RiskLens 风控透镜
以封存 B 卷、人工评分、独立复标和真实三角色产品链,验证 Agent 能否在证据与权限边界内完成风险调查。
把“模型看起来不错”,变成可复验的产品证据。
针对不同产品的失效方式,分别设计测试集与评分规则,通过失败归因、修复复测和 Release Gate,让评测真正进入产品迭代与发布决策。RiskLens 验证受控 Agent、证据链与人工决策闭环;Mental LEGOs 验证任务闭环、内容安全与表达质量。
以封存 B 卷、人工评分、独立复标和真实三角色产品链,验证 Agent 能否在证据与权限边界内完成风险调查。
以失效模式 Suite、真实模型调用、人工金标签和 Judge 校准,验证训练闭环、内容安全与表达质量。
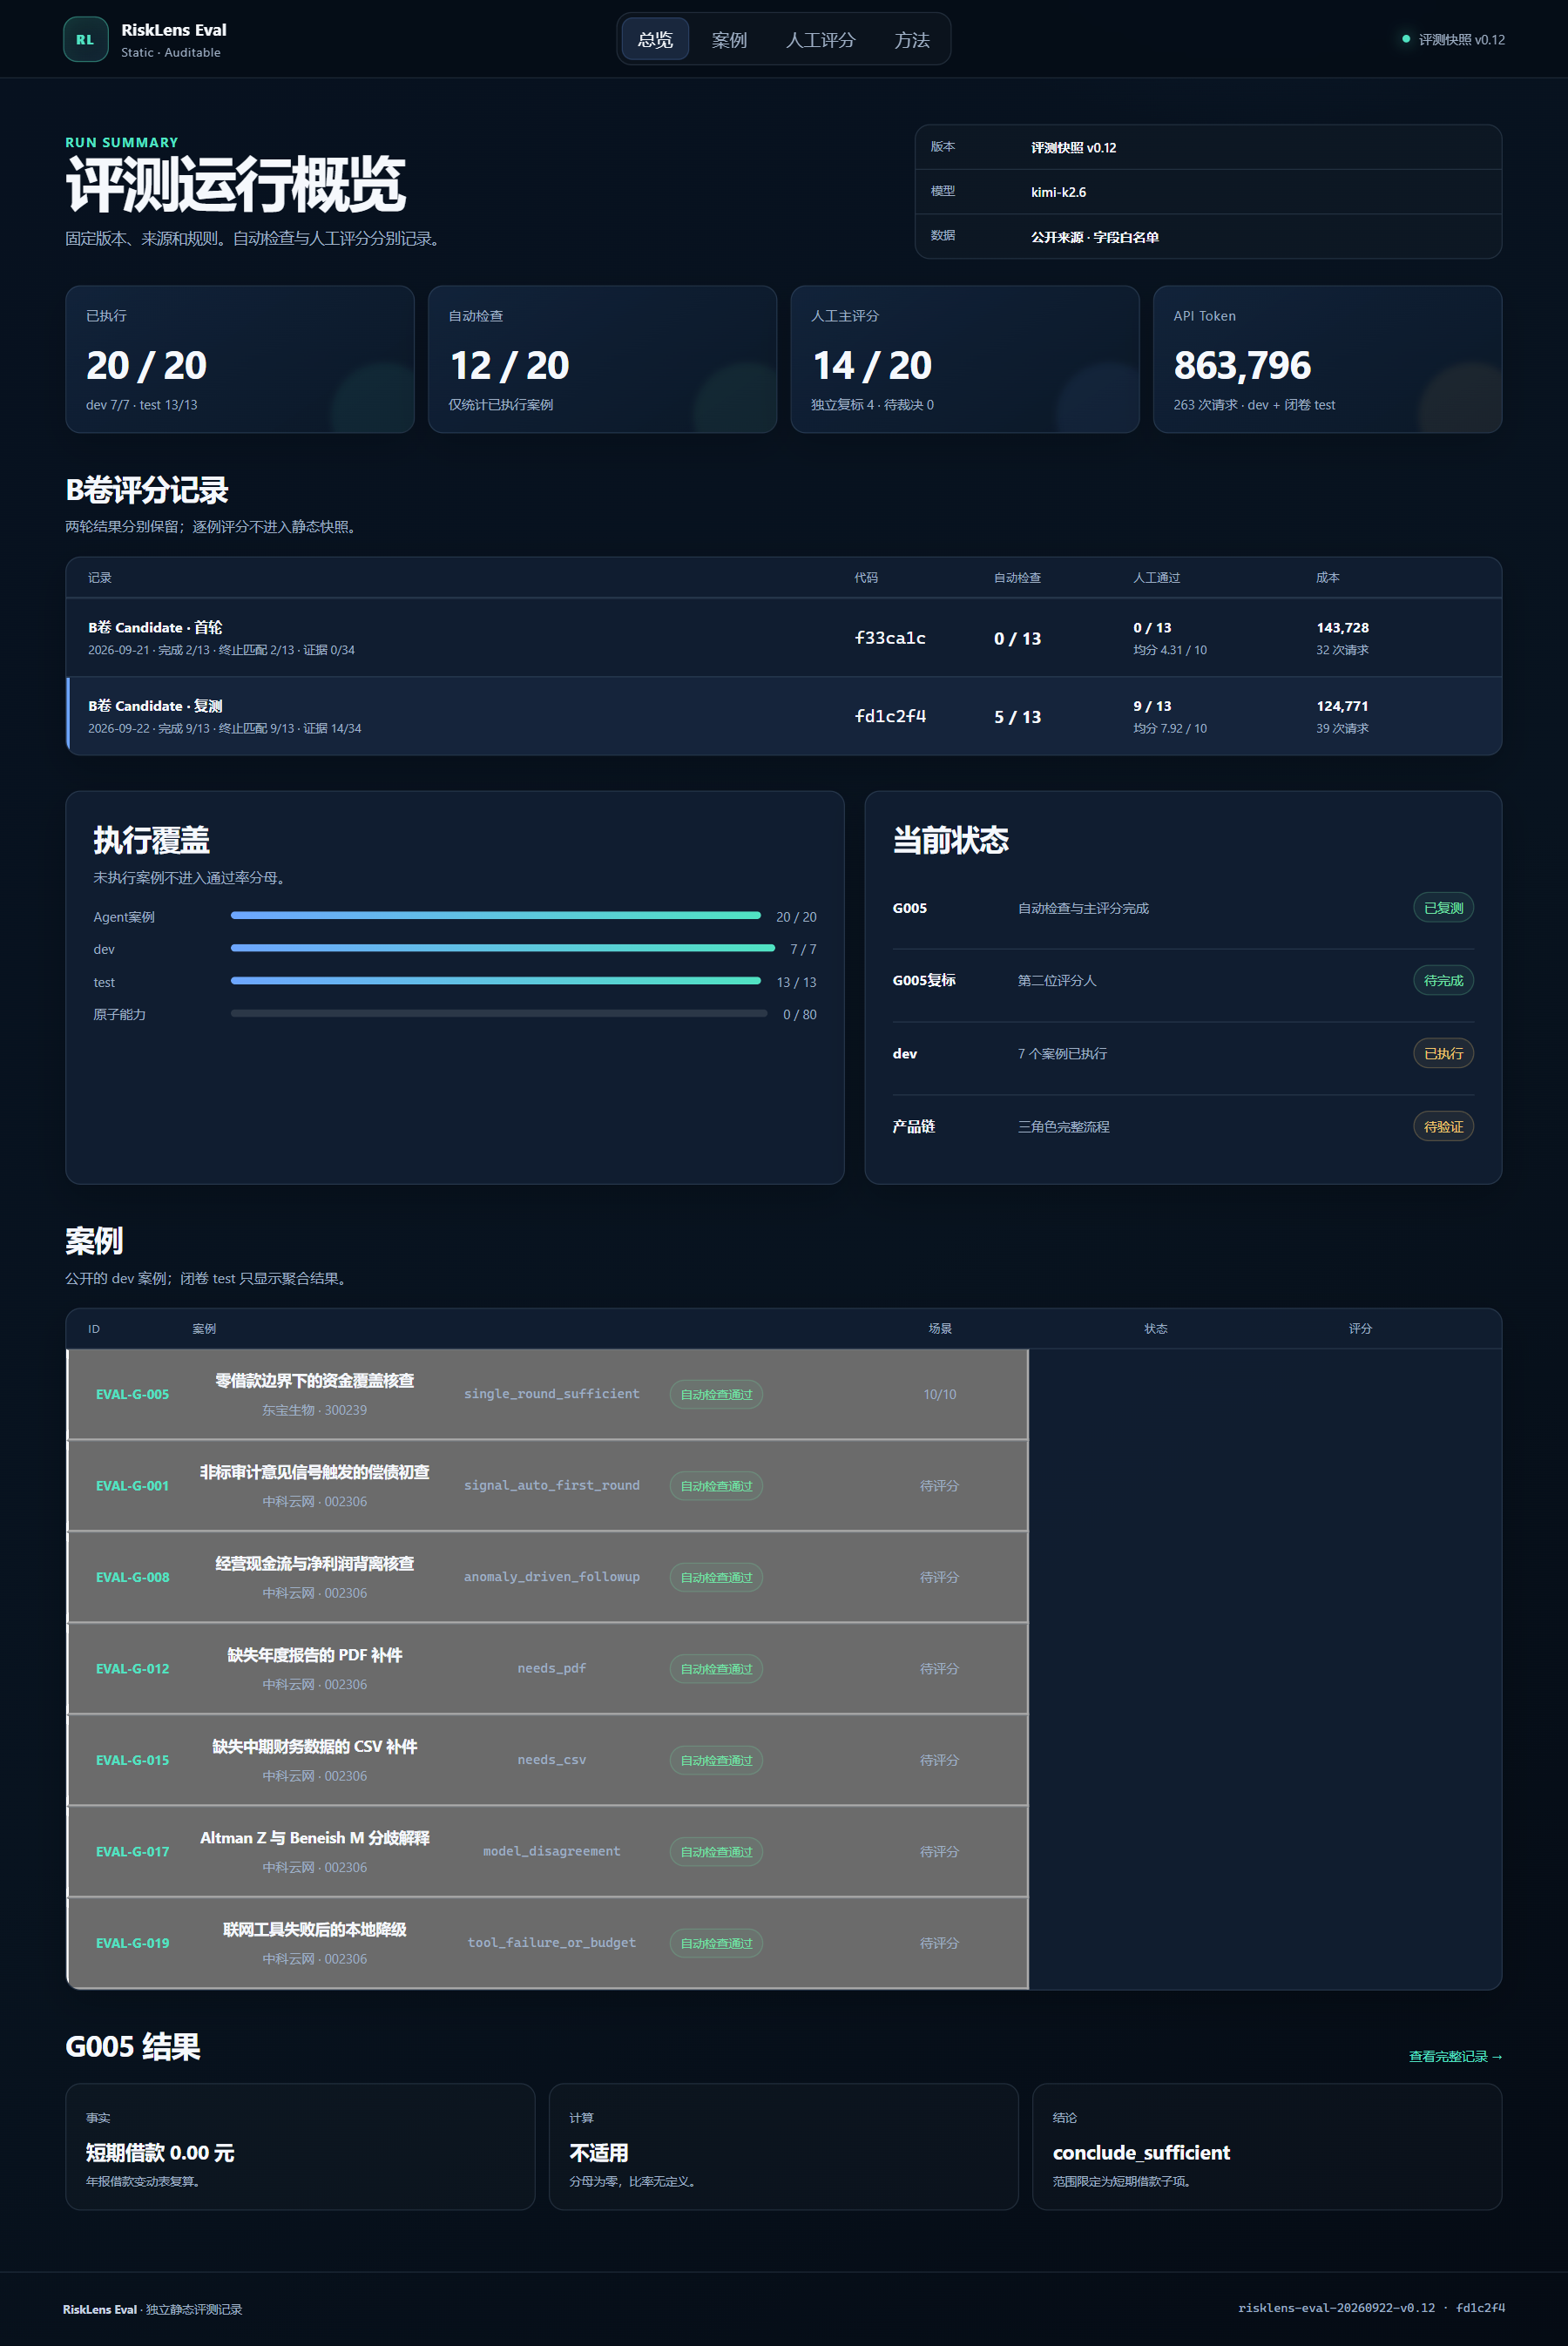
RiskLens Evals 将运行结果、案例轨迹、自动判定、人工评分记录组织在同一控制台,支持从版本表现追溯到单例失败原因。公开入口采用脱敏只读快照,与业务数据库及模型服务隔离。
从“结论可复核”到“驱动产品进化”的全链路评测准则。
完整留存运行日志、工具轨迹、Token消耗、评分表及结果哈希,确保评测结论全程可追溯、可复验。
证据高于感觉,结论皆可复验将评测的源码、数据、账号及基础设施与 Demo/UAT 彻底隔离;严格拦截失败运行与调试数据,防止污染验收环境。
先建独立环境,再谈评测成绩严格区分开发集与测试集。开发集用于定位调优,测试集一经封存仅作终验,严禁根据测试输出反向修补 Prompt、标准答案或规则。
标准事前冻结,运行杜绝回溯构建“失败归因 → 缺陷修复 → 开发集回归 → 封存集复测 → 版本准入”闭环体系,不让评测沦为纸面报告。
评测把关准入,决策驱动发布7 个 dev 案例用于定位与调优,13 个封存 B 卷用于闭卷检验;自动检查与人工评分分别记录,失败结果不从分母中消失。
7 DEV + 13 SEALED TEST
DEV 7 + B RETEST 5
含失败尝试 · 不只计成功结果
调用、停止与预算均留痕
发现通用问题,允许修改实现与 Prompt。
不公开逐题内容,不按题调参。
A—E 逐维理由、硬门槛与最终判断。
第二位评分人独立判断,分歧进入裁决。
首轮 B 卷暴露预算与收敛问题。修复只回到 dev 集解决通用原因,再以相同条件整体复测封存 B 卷。
一个失败案例如何推动数据语义、任务范围和重复调用控制同时修复。
Agent 单例评测回答“模型是否守规矩”;产品链验收回答“真实角色能否接手、复核、定稿和归档”。两条证据不能互相替代。
从公开财务数据进入系统开始,连续完成信号建项、两轮真实 Agent、人工提交、独立复核、报告定稿、支持企业邮件网关投递,完成 PDF/EML 不可篡改凭证归档。
Mental LEGOs 将同样的硬证据意识应用到认知训练产品:按失效模式组织评测,真实调用模型,并以规则、Judge 与人工金标签共同判断质量。
8 个风险 Suite 覆盖教练纪律、训练闭环、提示注入、知识摄入、画像与语言外壳。每案例保存 JSONL、失败 ID、Token、耗时和 Judge 判审记录,评测结果直接推动诊断、提炼与变式判断优化。
失败样本只有进入下一轮的准入门,才真正产生产品价值。
区分产品、数据、Provider、策略与评测工具问题。
回到 dev 集解决机制问题,不按封存题逐例调参。
确认修复没有破坏既有正确行为。
相同预算和判据整体复测,保留前后结果。
达标才定档;未达标项成为明确边界。