Agent 架构实践 · AI AGENT ARCHITECTURE

看见 harness
在运行Watch the harness think.

一个 Windows 桌面应用,把 Claude Code 的 20 个底层 harness 机制黑盒透明化
亲手触发、当场看见,实现对 Agent 行为的深度可观测。
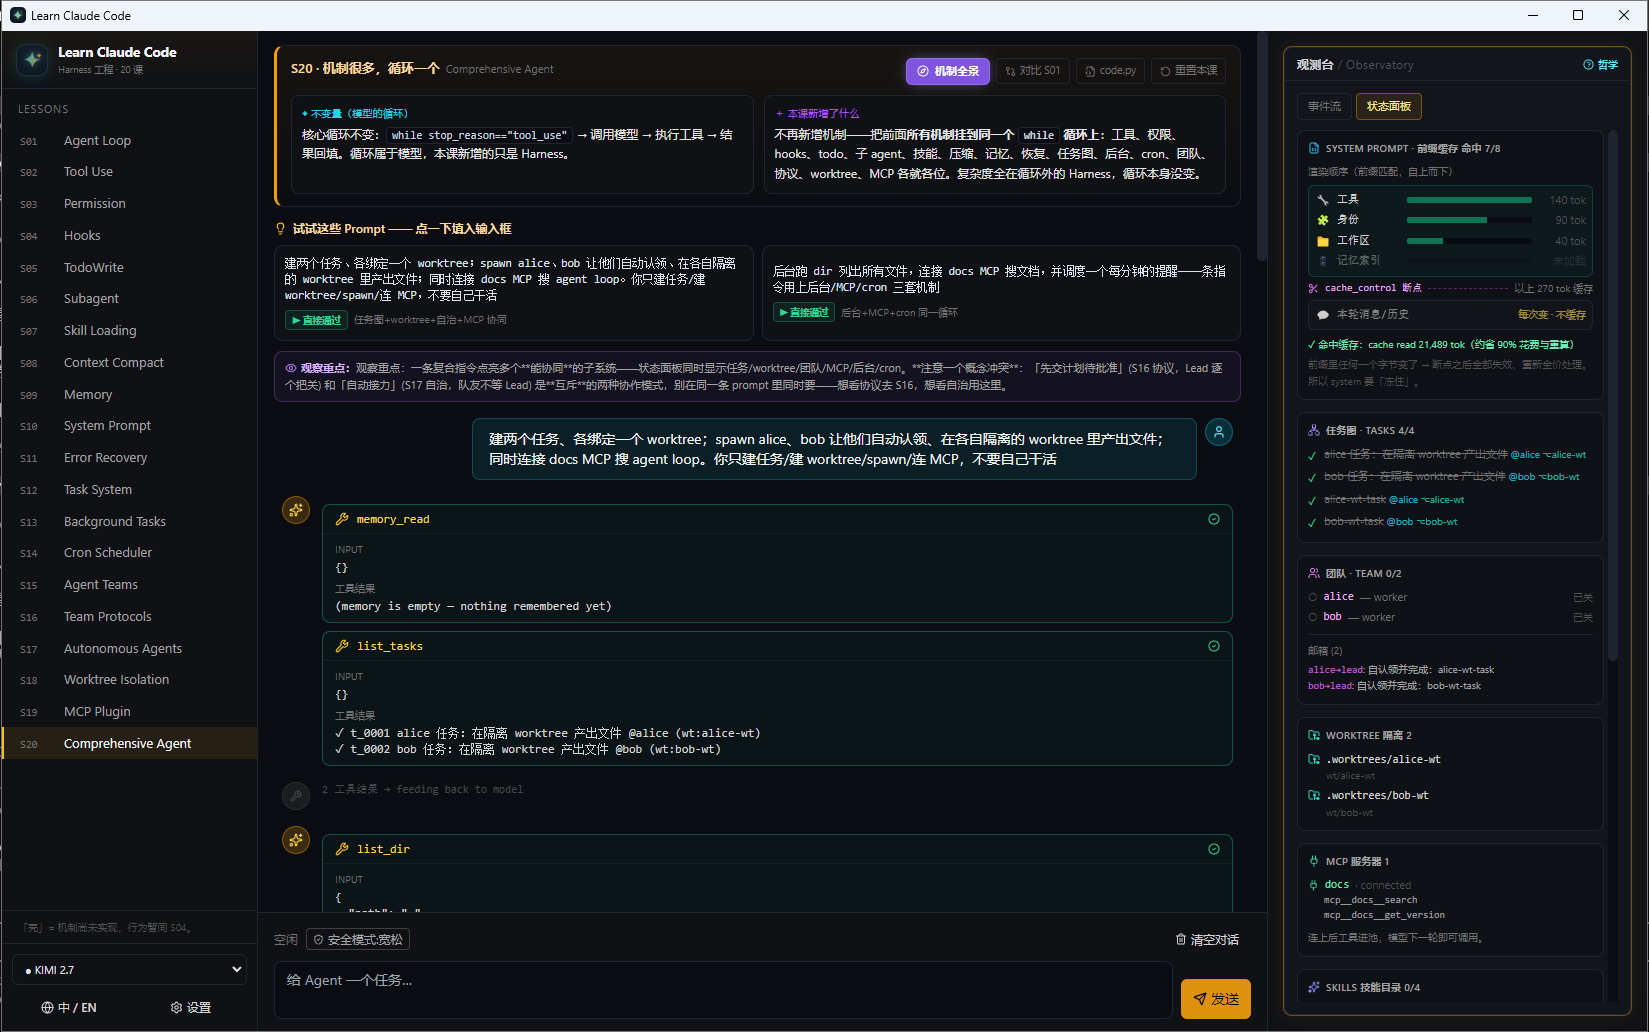
底层栈:Electron Runtime · React / TypeScript · Multi-LLM Engine
核心特性:真实沙箱执行 · S01–S20 全真实现
Harness Deck 主界面:聊天、实时事件流与状态面板
为什么做 · The Why

harness 很抽象——
因为你看不见它。

文档告诉你 memory、subagent、prompt caching 怎么工作,但它们在你眼前始终是一段黑盒。让我下定决心做这个的,是原仓库 learn-claude-code 的一句话:

能力来自模型训练,而非外部代码编排。“Agency comes from model training, not from external code orchestration.”

既然能力来自模型、harness 只是让它施展的运行环境——那理解 harness 最好的方式,就不是读它,是看它跑。这个客户端只做好一件事:让你发一句话,就当场看见机制真实发生。

90 秒运行直击 · LIVE RUN

发一句话,看它真实发生。

核心体验 · The Core

从“黑盒”到透明,
定义 Agent 的可观测工程底座。

不靠讲解,靠亲手触发。你发一句话,就能在实时事件流与状态面板里看到机制真实发生——而这正是 AI 开发者最核心的功底:对 Agent 行为的实时调试与洞察。

01看见缓存命中token 与成本当场掉下来,不是文档里的数字。
02看见子 agent 派生事件流里冒出一条缩进的子对话,独立上下文。
03看见错误恢复遇错自动退避重试,观测台里的黄色「恢复」事件一眼看见。
覆盖 · Scope

20 个机制,全部真实实现。

围绕一个始终不变的 agent loop,每次只新增一个机制——从最小循环到多 Agent 协同。不是模拟,是真跑。

基础能力 Core
S01Agent LoopOne loop & Bash is all you need
S02Tool Use加一个工具,只加一个 handler
S03Permission先划边界,再给自由
S04Hooks挂在循环上,不写进循环里
复杂任务 Complex Work
S05TodoWrite没有计划的 agent 走哪算哪
S06Subagent大任务拆小,每个小任务干净的上下文
S07Skill Loading用到时再加载,别全塞 prompt 里
S08Context Compact上下文总会满,要有办法腾地方
记忆与恢复 Memory & Recovery
S09Memory记住该记的,忘掉该忘的
S10System Promptprompt 是组装出来的,不是写死的
S11Error Recovery错误不是终点,是重试的起点
长任务 Long-running
S12Task System大目标拆成小任务,排好序,持久化
S13Background Tasks慢操作丢后台,agent 继续思考
S14Cron Scheduler定时触发,不需要人推
多 Agent Multi-agent
S15Agent Teams一个搞不定,组队来
S16Team Protocols队友之间要有约定
S17Autonomous队友自己看板,有活就认领
S18Worktree Isolation各干各的目录,互不干扰
扩展与整合 Extend & Assemble
S19MCP Plugin能力不够?插上 MCP
S20Comprehensive机制很多,循环一个
◆ 真实机制,非动画模拟 —— 每个面板背后都是真的在跑
运行架构 · RUNTIME ARCHITECTURE

让 Agent 的每一次决策与执行,都可观测。

Harness Deck 沿 Electron 双进程边界拆分职责:渲染进程负责编排 Agent Loop 与实时呈现,主进程承接模型调用、工具执行、状态持久化与安全隔离;所有关键动作统一进入事件流,形成可追踪、可复盘的运行轨迹。

Harness Deck · Runtime Architecture

一个 Agent Loop,连接决策、执行与观测

计划、模型响应、工具调用与状态变化进入同一条事件流;需要系统权限的任务经 IPC 交由主进程受控执行,结果回传观测台并持久化。

用户输入 User Input · prompt ◤ RENDERER PROCESS · React / TypeScript 能动性 Agency —— agent 在这里决策 Agent Loop while stop_reason == "tool_use" src/lib/agentLoop.ts AgentEvent Bus pub / sub —— agentEvent.ts · zustand ◇ OBSERVATORY · 观测台(三面板) Event Stream 实时事件流 ● 能动 ● 编排 State Panel 状态面板 memory · tasks · cache … Mechanism Panels · S01 → S20 每课一个可视化面板 —— 把抽象机制画成看得见的东西 loop · tool · permission · hooks · subagent · memory cache · recovery · task · cron · team · worktree · mcp … IPC ⇄ preload · contextIsolation —— 安全隔离边界 ◥ MAIN PROCESS · Electron Runtime 编排 Orchestration —— 真实的流式 / 执行 / 持久化 LLM Stream (SSE) ipc/llm.ts · 真实 token & 成本 Tool Executor ipc/tools.ts Sandbox child_process · deny-list · 每课独立目录 Persistence + Cleanup Daemon ipc/persist.ts · .memory / .tasks(白名单持久化) MCP ipc/mcp.ts · JSON-RPC safeStorage 加密密钥 · 本地 Multi-LLM Engine 外部 · 用你自己的 API Key Anthropic · Moonshot · Zhipu Deepseek · Qwen 每步 emit → 调用 / 流式 工具调用
渲染进程 · 能动性(agent 决策) 主进程 · 编排(真实执行) —— 关键决定:loop 放渲染层,只为把每一步喂给观测台
技术决策 · Development Diary

不只是写代码,
是想清楚技术路线。

做这个产品时的几个关键岔路口——每一个都不是唯一解,记录我基于权衡后的深度抉择。

DECISION 01

Electron,而非 Tauri

要生态,还是要体积?

背景
主进程要跑各家 LLM 的 Node SDK、真实 child_process 执行工具、safeStorage 加密密钥。
决定
选 Electron——Tauri 的 Rust 后端会让"真工具执行 + 多 provider"复杂化。用体积换生态与开发速度,对一个教学产品是划算的。
DECISION 02

真沙箱,而非纯模拟

"看它发生"能造假吗?

背景
产品的立命之本是"看它真的发生"。模拟一旦被看穿,可信度归零。
决定
选 真执行 + 护栏:命令真跑,但限制在沙箱目录、7 条黑名单硬拦截、strict 模式逐条确认。真实与安全用护栏平衡,不用假装。
DECISION 03

20 个机制全做真

难的那几个,要不要糊弄?

背景
S10–S20 里有些机制(多 Agent、worktree、MCP)做真成本很高,模拟最省事。
决定
划一条诚实边界:能真则真;所有执行逻辑必须真实,仅对"不可逆/破坏性"的高危操作实施隔离模拟,并把安全模式"宽松" vs "严格"摊开给用户选。确保准确性与系统安全性的平衡。
DECISION 04

Agent loop 放渲染进程

性能优先,还是可观测优先?

背景
loop 放主进程更"正统",但它每一步的内部状态就很难实时喂给 UI。
决定
把 loop 放渲染进程,通过 pub/sub 把每一步事件推给观测台;主进程只做流式/工具/持久化。架构决策:将可观测性确立为该产品的核心体验指标,优先于架构的传统性能优化。
产品演进 · Evolution

三次迭代,
把黑盒做成观测体系。

  1. V1.0
    POINT 01

    数据显性化

    从“隐性 Bash”到“显性事件流”
    背景
    核心决策(“为什么调这个工具”)在 Bash 里一闪而过,用户抓不住。
    进化
    设计实时事件流 + 状态面板,把命令行输出转成可视化信息流——“模型思维”变成可感知的“数据交互”。
  2. V1.2
    POINT 02

    体验产品化

    从原型到平台
    背景
    MVP 阶段不只是功能堆砌,更是用户心流路径的设计。
    进化
    通过开场引导、品牌化 UI、双色轴视觉语言与三面板布局重构,做对用户友好的可观测界面。开场引导页讲 Agency vs Harness;事件流用两色区分:青 = 能动性(模型决策),琥珀 = harness(编排执行)——颜色不是装饰,是把“能力来自模型”编码成一眼可读的信息。再加对比模式(不变的 loop vs 逐步新增机制并排、差异紫光高亮)——固定锚点 + 反复强化。
  3. V2.0
    POINT 03

    机制真实化

    从全能模拟到机制真实现
    背景
    让 AI 把 S10–S20 一次性做完,它交付了“完成”——但实际是渲染层的确定性模拟。
    进化
    靠“真 vs 模拟”判据在 V1.6 抓出 AI 偷懒,V2.0 把 S10–S20 全部真实化;划一条诚实边界:所有执行逻辑必须真实,仅对高危操作实施隔离模拟,并把安全模式“宽松” vs “严格”摊开给用户选,确保准确性与系统安全性的平衡。再用机制全景讲透 20 机制的组合 / 互斥 / 简化,构建“哪些能协同、哪些有冲突”的认知地图。
下一步 · What's Next

深入可观测性的底层逻辑Dig deeper into the observable architecture.

通过源码洞察架构,查看部署实践,或探索更多 AI 工程成果。

Connect with Juicy 👋

想聊聊 AI Agent 工程、可观测性,或者有合作的想法?很高兴认识你——直接写信给我就好。

juicykwok2019@gmail.com